为什么需要 CosId
服务的每个副本都要生成 ID(主键、订单号、事件 ID),而且不能与其他副本生成的 ID 冲突。表一旦分片,或者需要在插入之前就拿到 ID,数据库自增列就不再适用;随机 UUID 有 128 位且无序,B+ 树索引在每次插入时都可能页分裂。
CosId 在应用进程内生成这样的 ID,每个 ID 都不需要网络调用,并替你处理保证唯一所需的协调工作:
- Snowflake ID 要求每个运行中的实例持有不同的机器号。CosId 从你已有的存储(Redis、关系数据库、MongoDB、ZooKeeper 或 CosId Proxy)租用机器号,持续续约,租约丢失时停止生成,因此两个实例不会共用同一个机器号。
- 号段 ID 需要一个中心计数器。CosId 每次从存储取一段 ID(号段),并在后台预取后续号段,生成过程始终在内存中完成。
- 时钟会回拨。 CosId 会等过短暂的时钟回拨,拒绝跨越过长的回拨继续生成,并记住每个机器号最后使用的时间戳,避免重启后的实例重复使用。
生成器一览
| 生成器 | ID | 有序性 | 依赖 | 适用场景 |
|---|---|---|---|---|
SegmentChainId | long | 单实例单调递增,跨实例接近连续 | 号段存储 | 需要较短、接近连续的数字,例如主键、订单号。号段的默认模式 |
SnowflakeId | long(63 位) | 按时间有序 | 每个实例一个机器号 | ID 需要携带生成时间,或启动后不想再依赖存储 |
CosIdGenerator | String,15 到 17 个字符 | 按时间有序 | 每个实例一个机器号 | 实例数量非常多(最多约一百万个机器号),并且需要字符串 ID |
DefaultSegmentId | long | 单实例单调递增 | 号段存储 | 很少使用:号段链更快,用法一样简单 |
更详细的选择方法见 ID 生成器。
分布式 ID 需要满足什么
- 唯一性:同一类 ID 内唯一。
t_order的 ID 在各副本之间不能冲突,至于是否与t_order_item的 ID 重复并不重要。 - 有序性:有序的键只会追加写入 B+ 树索引。没有全局时钟时,分布式生成器能做到的是单实例单调递增、跨实例趋势递增,CosId 的生成器正是如此。
- 吞吐量与延迟:每次插入都要生成 ID。应当关注尾延迟(P99.99)而不是平均值:每个号段阻塞一次网络调用的生成器,问题会体现在尾延迟上。
- 自治性与可用性:每个 ID 都调用存储的生成器会随存储一起失败。号段链会预留 ID,Snowflake ID 只在启动和续约时需要存储。
- 存储空间:64 位的键在每个二级索引里只占 UUID 的一半空间。
| 方案 | 唯一 | 有序性 | 吞吐量(ops/s) | P99.99(µs/op) | 依赖 | 大小 |
|---|---|---|---|---|---|---|
| UUID | 是 | 无序 | 3,078,638 | 0.325 | 无 | 128 位 |
| SnowflakeId | 是 | 单实例单调递增,趋势递增(受各主机时钟影响) | 4,096,000(理论上限,每毫秒 4096 个) | 0.244 | 时钟、机器号 | 64 位 |
| DefaultSegmentId | 是 | 单实例单调递增,趋势递增(受步长影响) | 29,506,073 | 46.624 | 号段存储 | 64 位 |
| SegmentChainId | 是 | 单实例单调递增,趋势递增(受步长、安全距离影响) | 127,439,148 | 0.208 | 号段存储,并预留 ID | 64 位 |
以上数据是 CosId 1.x 时期在单机上的历史 JMH 结果,出自分布式 ID 方案对比,用于说明各方案的相对开销,并不代表你的硬件能达到的数值。运行方法见 JMH 基准测试。
单调递增与趋势递增
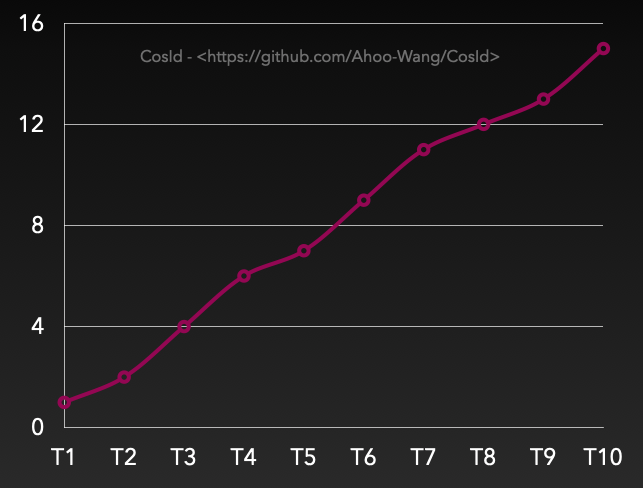
单调递增:若 Tn+1 > Tn,则 F(Tn+1) > F(Tn)。数据库自增主键是单调递增的,但不连续:可能跳过某些值。
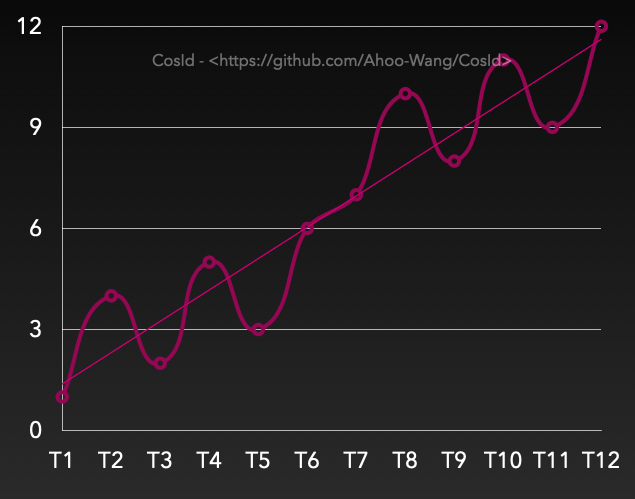
趋势递增:后生成的 ID 总体上更大,但在一个短窗口内可能乱序。Snowflake ID 的窗口来自各主机之间的时钟差异;号段 ID 的窗口来自每个实例持有的号段大小。